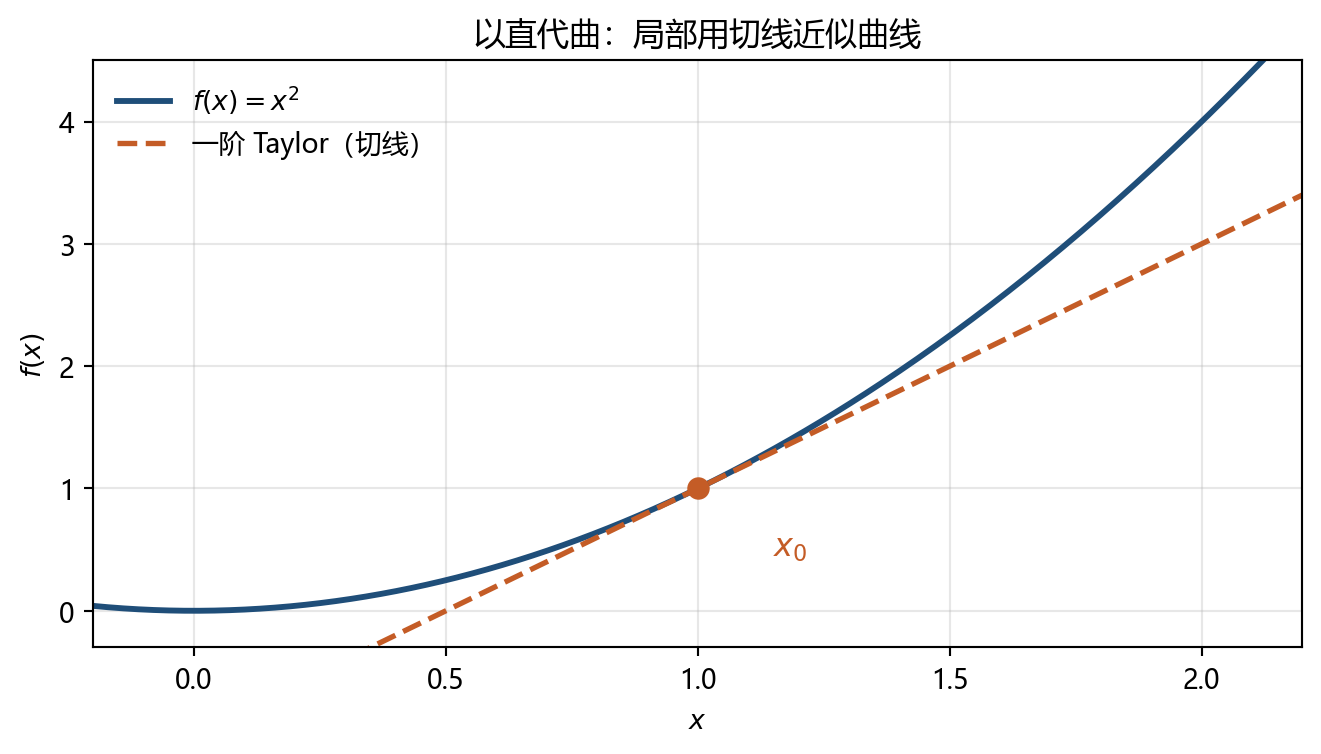
读龚昇《简明微积分》第 3.3 节时,书上先讲 Taylor 展开,再讲 极值。深度学习里天天用的 梯度下降,本质上就是这两件事的高维版本:用局部近似决定怎么走,用导数为零刻画「走到了没有」。
本文用一元函数把这条线画清楚,再自然过渡到多元 loss。
1. Taylor:在一点附近把函数写成多项式
设 f 在 x_0 附近足够光滑,则
f(x) = f(x_0) + f'(x_0)\,(x-x_0) + \frac{1}{2}f''(x_0)\,(x-x_0)^2 + \cdots
只保留一阶,就是切线近似(线性化):
f(x) \approx f(x_0) + f'(x_0)\,(x-x_0)
几何上:曲线在 x_0 附近,用切线代替。
多元时,x 换成参数向量 w,一阶导数换成梯度 \nabla f:
f(w) \approx f(w_0) + \nabla f(w_0)^\top (w-w_0)
深度学习里的 loss L(w),在当前参数附近正是这样被近似的。
2. 极值:导数为零的点是候选
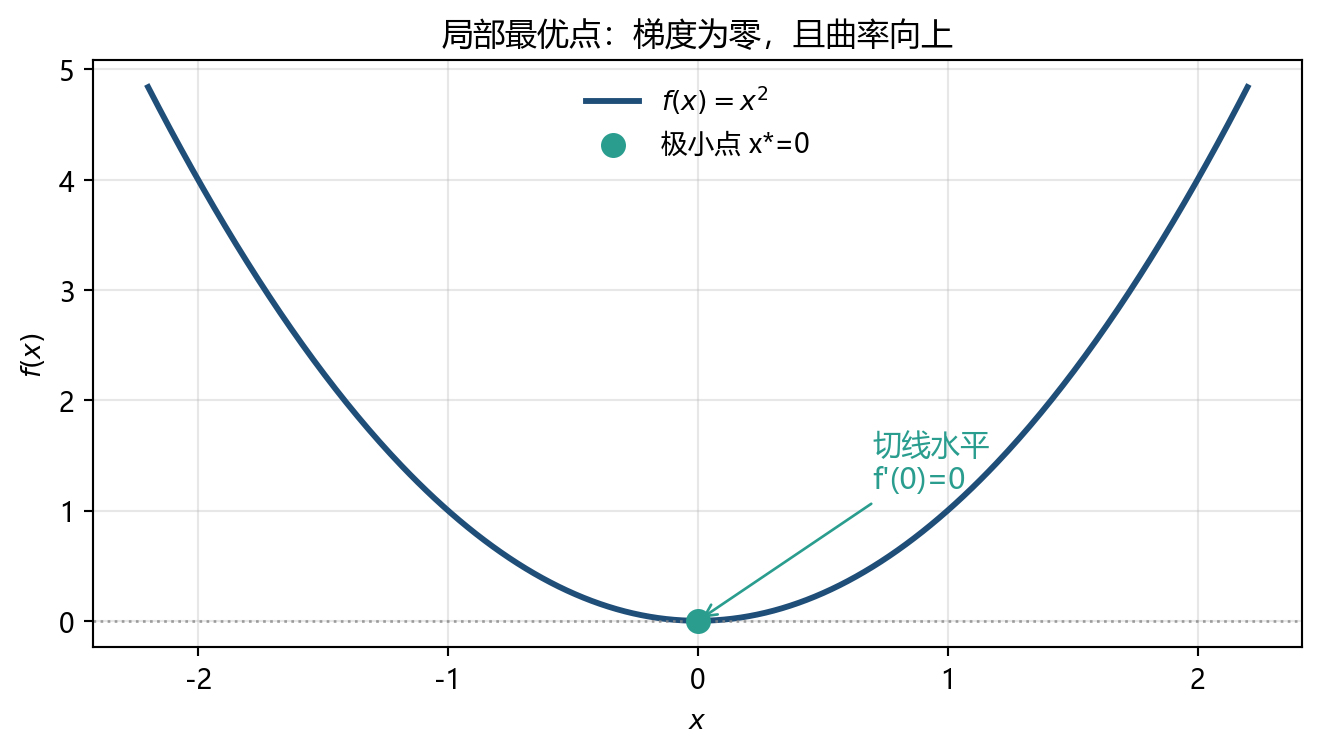
若 x_* 是开区间内的局部极值点,且 f'(x_*) 存在,则必要条件是
f'(x_*) = 0
几何上:极值处切线水平。
再用二阶信息判定:
| 条件 | 结论 |
|---|---|
| f'(x_*)=0 且 f''(x_*)>0 | 局部极小 |
| f'(x_*)=0 且 f''(x_*)<0 | 局部极大 |
| f'(x_*)=0 且 f''(x_*)=0 | 需更高阶信息 |
多元对应:
\nabla L(w_*) = 0
并看 Hessian 是否正定(局部极小)、负定(局部极大)或不定(鞍点)。深度学习的 loss 景观里,鞍点很常见。
3. 梯度下降:用一阶 Taylor「往下走」
训练时往往不解方程 \nabla L=0,而是迭代逼近。
在当前点 w_t 只保留一阶:
L(w_t + \Delta w) \approx L(w_t) + \nabla L(w_t)^\top \Delta w
要让近似后的 loss 变小,取
\Delta w = -\eta\,\nabla L(w_t),\qquad \eta>0
因为
\nabla L(w_t)^\top \bigl(-\eta\nabla L(w_t)\bigr) = -\eta\,\|\nabla L(w_t)\|^2 \le 0
一阶近似下,loss 不会上升。这就是梯度下降:每一步都在用 Taylor 的线性部分,沿最陡下降方向挪一点。
一元例子:f(x)=x^2,f'(x)=2x,更新为
x_{t+1} = x_t - \eta\, f'(x_t) = x_t - 2\eta\, x_t = (1-2\eta)\,x_t
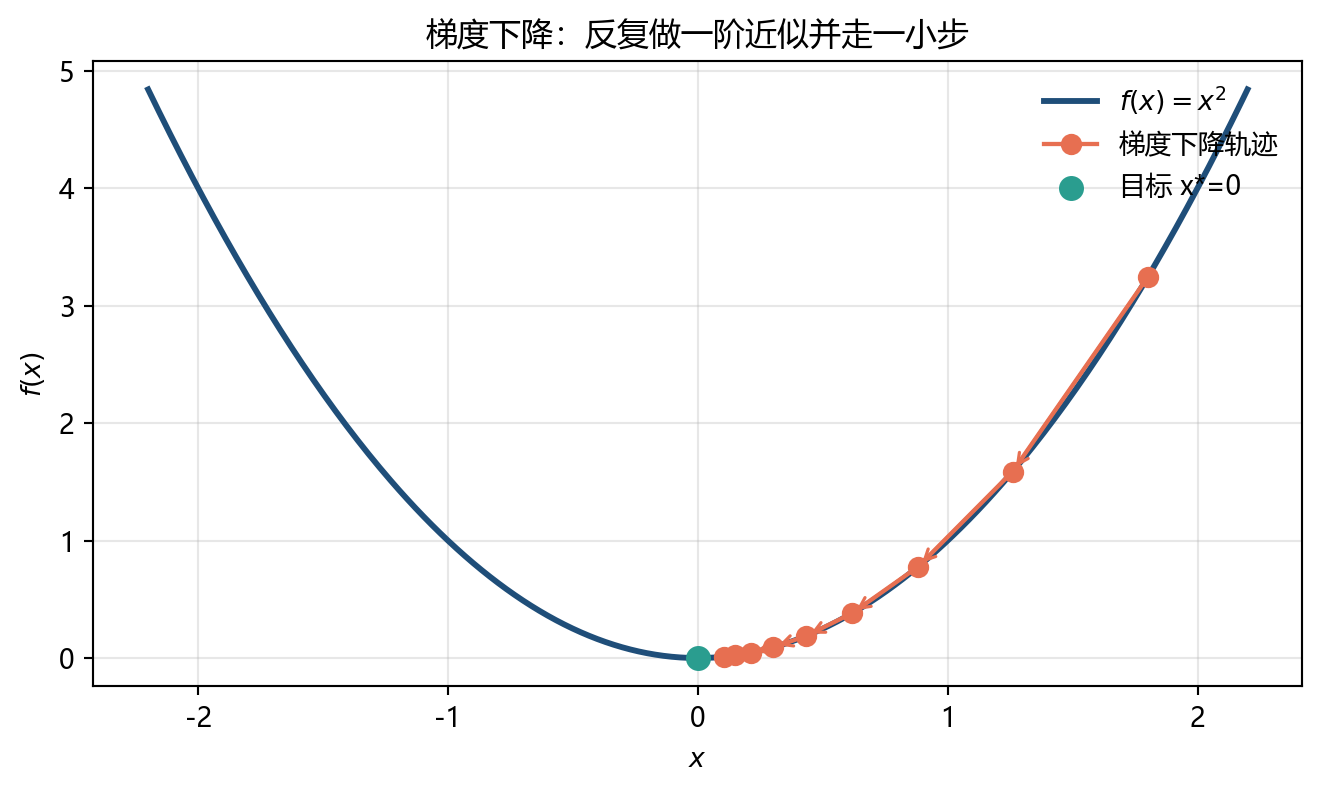
步长 \eta 太大时,会离开「一阶近似仍然有效」的邻域,真实函数值可能不降反升——这正是 Taylor 余项在提醒你:线性化只在局部靠谱。
4. 二维几何:梯度指向最陡上升
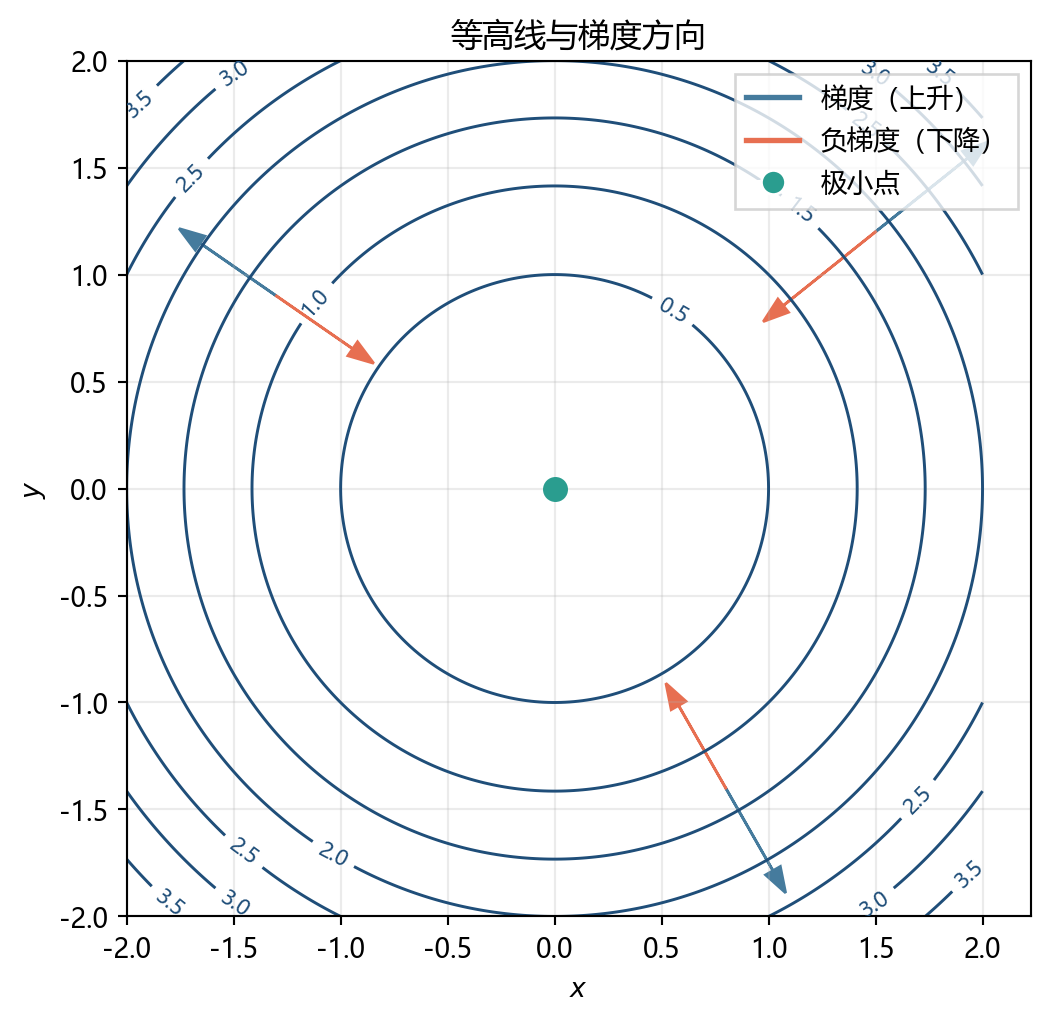
对二元函数 f(x,y)=\frac12(x^2+y^2),梯度为
\nabla f(x,y) = (x,\, y)
它垂直于等高线,并指向函数值升高的方向。因此 -\nabla f 指向下山。
5. 四者如何串成一条线
Taylor 展开
   │
   ├─ 一阶:∇L  → 给出下降方向 → 梯度下降
   │
   └─ 二阶:H   → 判断极小 / 极大 / 鞍点
                 → 也启发牛顿法、自适应优化的直觉

极值理论:∇L = 0 是局部最优点的必要条件
梯度下降:不断减小 ‖∇L‖,试图走到这种点附近| 概念 | 在优化里的角色 |
|---|---|
| Taylor(一阶) | 局部把 loss 当成平面,决定怎么走 |
| 梯度 \nabla L | 平面的最陡上升方向 |
| 梯度下降 | 反复做「一阶近似 + 走一小步」 |
| 局部最优点 | 理想停靠点:\nabla L \approx 0,附近是「碗底」 |
| Taylor(二阶) | 判断碗底还是马鞍;解释为何有时卡住 |
对应回《简明微积分》3.3:
- 会用导数做局部近似(Taylor)
- 用一阶 / 二阶条件找并判定极值
深度学习只是把对象换成高维 L(w),把「解方程 f'=0」换成「用梯度迭代下山」——数学骨架没有变。
6. 小结
- 展开:告诉你局部长什么样(先直线,再抛物线)。
- 极值:告诉你最优点满足什么(梯度为零 + 曲率合适)。
- 梯度下降:用展开的一阶信息,一步步逼近极值点。
- 局部最优点:下降过程希望到达的地方;若曲率不对,可能是鞍点而非真正的极小。
下一步若继续读《简明微积分》,可把重点放到 6.2 偏微商 与 7.1 梯度:那是把本文的一元故事正式升到多元。